Qué es el SEO técnico y cómo revisar cada pieza de tu web
El SEO técnico es la parte del posicionamiento que se asegura de que Google y los robots de la IA puedan rastrear tu web, entenderla e indexarla sin tropiezos: robots.txt, sitemaps, redirecciones, canónicas, JavaScript, velocidad, móvil, HTTPS, datos estructurados y hreflang. No escribe tus textos, pero sin él nadie llega a leerlos.
El SEO técnico es la fontanería de una web. Nadie presume de tuberías, pero cuando una gotea te enteras. Una empresa puede tener los mejores textos de su sector y no salir en Google porque una etiqueta mal puesta le dice al buscador que sus páginas son copias de otra web. Lo encontramos esta misma semana en una web real, y no fue la única sorpresa.
Si lo que buscas es una lista corta para repasar tu web en una tarde, la tienes en nuestra guía de auditoría SEO y GEO. Aquí abrimos el capó: qué hace cada pieza, qué dice Google de ella, cómo se rompe y cómo se arregla. Y con datos propios, porque el 7 de noviembre de 2026 pasamos trece comprobaciones técnicas por 76 webs de pymes españolas.
Qué es el SEO técnico y en qué se diferencia del resto del SEO
Respuesta corta: el SEO técnico se ocupa de las dos primeras fases de la búsqueda. Google explica que su buscador trabaja en tres: rastreo (sus robots descargan páginas), indexación (las analiza y las guarda) y publicación de resultados (elige qué enseñar en cada búsqueda). No todas las páginas superan las tres, y aquí se trata de que las tuyas no se queden por el camino.
El resto del posicionamiento se construye encima. El contenido decide si una página merece salir para una búsqueda; los enlaces y las menciones, cuánta confianza le da Google. Si el robot no llega, o se lleva una versión equivocada, lo demás no tiene sobre qué apoyarse.
- El técnico
- Que el buscador pueda entrar, leer y guardar la versión correcta de cada página: códigos de respuesta, robots.txt, sitemap, canónicas, redirecciones, JavaScript, velocidad, móvil, HTTPS y hreflang.
- El de contenido (on page)
- Que cada página conteste a una búsqueda mejor que las de la competencia: tema, título, encabezados, texto e imágenes.
- El de fuera de la web (off page)
- Lo que otros dicen de ti: enlaces, menciones en prensa y directorios, reseñas.
- La capa GEO
- Que los asistentes de IA puedan leerte y citarte. Usa la misma base técnica y le suma sus propios robots.
Cuánto pesa según el tamaño de tu web
Mucho menos de lo que asusta en una web pequeña y mucho más de lo que parece en una grande. En una web de servicios de veinte páginas hecha con WordPress, casi todo se resuelve con una buena configuración inicial y una revisión de vez en cuando. En una tienda con miles de productos, filtros y tres idiomas, es trabajo de todas las semanas.
Google lo dice a su manera. Su guía del presupuesto de rastreo está pensada para webs de más de un millón de páginas que cambian cada semana, o de más de 10.000 que cambian a diario. Para el resto, según la misma guía, basta con tener el sitemap al día y mirar el informe de indexación con regularidad.
Rastreo e indexación: que Google pase no significa que te guarde
Respuesta corta: rastrear es descargar la página e indexar es decidir guardarla. Google aclara que un código 200 no garantiza la indexación, solo que el contenido pasa a la siguiente fase. Lo que sí controla tu servidor es el código con el que responde, y cada código le cuenta al buscador una cosa distinta.
| Código | Qué significa | Qué hace Google |
|---|---|---|
| 200 | La página existe y se entrega | La tiene en cuenta para el índice, sin garantía de que la guarde |
| 301 y 308 | Redirección permanente | Sigue el salto y toma el destino como señal fuerte de cuál es la URL buena |
| 302 y 307 | Redirección temporal | Sigue el salto, pero como señal débil: la dirección vieja puede seguir siendo la canónica |
| 404 y 410 | No existe | La saca del índice si estaba y, si es nueva, ni la procesa; con el tiempo la visita menos |
| 429 | Demasiadas peticiones | Lo trata como un error de servidor y rastrea más despacio |
| 500, 502 y 503 | Error del servidor | Frena el rastreo; conserva un tiempo lo indexado, pero si el fallo sigue acaba quitándolo |
Fuente: Google, «How HTTP status codes affect Google's crawlers», actualizada el 4 de febrero de 2026. Google sigue hasta 10 saltos de redirección.
El soft 404, el error que no parece un error
Un soft 404 es una página que dice «no encontrado», o que está vacía, pero responde con un 200. Google acaba detectándola y la marca en Search Console. Mientras tanto la sigue visitando, y por eso su guía del presupuesto de rastreo pide eliminarlas. También cuenta como soft 404 redirigir montones de URLs viejas a la portada, una costumbre muy extendida cuando se rehace una web.
Comprobarlo lleva diez segundos: escribe en el navegador tudominio.com/una-pagina-que-no-existe. Lo correcto es ver tu página de error con un código 404, que puedes leer en la pestaña Red de las herramientas del navegador. En la muestra, 72 de las 76 webs respondían bien. Dos mandaban la URL inventada a la portada, otra a una página de acceso, y en la última la prueba no fue concluyente.
Dónde mirar si Google te indexa
En Google Search Console, el informe Páginas (dentro de Indexación) separa lo indexado de lo que no y da el motivo. Hay dos estados que confunden. «Descubierta: actualmente sin indexar» quiere decir que Google conoce la URL pero aún no ha ido a por ella, algo que suele mejorar con enlaces internos y un servidor ágil. «Rastreada: actualmente sin indexar» significa que la visitó y, por ahora, ha decidido no guardarla; ahí toca preguntarse si esa página aporta algo que no tengan ya otras de tu web.
robots.txt y sitemap: la puerta y el mapa
Respuesta corta: el robots.txt dice a los robots por dónde no deben pasar y el sitemap les entrega la lista de URLs que quieres que conozcan. Son dos ficheros pequeños, y los dos pueden hacer mucho daño con una sola línea.
Qué pasa cuando el robots.txt falla
Casi nadie lo sabe, pero a Google le importa tanto lo que pone el robots.txt como el código con el que responde. Esto dice su especificación, actualizada el 23 de octubre de 2026:
- Si responde 404 o cualquier otro error 4xx (salvo el 429), Google entiende que no hay restricciones y rastrea todo.
- Si da un error de servidor (5xx), durante las primeras 12 horas deja de rastrear la web entera mientras lo reintenta. Luego usa la última versión buena durante 30 días.
- Si redirige, sigue al menos cinco saltos; si no encuentra el archivo, actúa como ante un 404.
- Lo guarda en caché hasta 24 horas, así que un cambio no se nota al momento.
- Solo lee los primeros 500 KiB. Lo que pase de ese tamaño, lo ignora.
La moraleja es rara pero cierta: un servidor que falla al entregar el robots.txt hace más daño que no tener robots.txt. Y otra que sale de la guía de canónicas de Google: bloquear una URL en el robots.txt no la saca del buscador, que puede indexarla sin su contenido si la encuentra enlazada. Para eso está la etiqueta noindex, y para que Google la lea, esa página no puede estar bloqueada.
Qué debe llevar el sitemap (y qué no)
Solo URLs que respondan 200, que quieras ver indexadas y que sean la versión canónica. Google toma el sitemap como una señal débil de cuál es la URL buena, de modo que uno lleno de redirecciones o de páginas con noindex contradice a tus otras señales. El campo lastmod sí lo usa, pero solo si es coherente y comprobable: si tu plugin pone la fecha de hoy a todas las URLs cada noche, deja de creérselo.
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://www.tudominio.com/servicios/reformas-de-banos/</loc>
    <lastmod>2026-10-14</lastmod>
  </url>
</urlset>
Un sitemap mínimo: dirección completa y canónica, y lastmod solo cuando cambia el contenido de verdad.
El sitemap fue justo el punto flaco de la muestra. Abrimos 831 URLs sacadas de 73 sitemaps y 53 tenían algún problema: 29 no respondían 200 (sobre todo redirecciones, alguna 404 y una con el texto literal «%POSTNAME%» en la dirección, resto de unos enlaces permanentes mal configurados), 6 llevaban noindex y 18 tenían la canónica apuntando a otra URL. Además, una web declaraba en su robots.txt un sitemap que da 404 y otra tenía el sitemap vacío.
Y el detalle que más gracia nos hizo: en 5 de las 73 muestras aparecía la entrada de ejemplo que trae WordPress al instalarse, «Hola mundo» o «Hello world». Cuatro seguían publicadas y abiertas al buscador.
Canonical y contenido duplicado: cómo decirle a Google cuál es la buena
Respuesta corta: cuando la misma página se abre en varias direcciones, Google agrupa las copias y elige una como canónica, la que enseñará y rastreará más a menudo. Tú le indicas tu preferencia, pero Google lo deja claro: es una pista, no una regla, y puede quedarse con otra si tus señales no cuadran.
Las copias salen solas. Con y sin www, por http y por https, con barra al final y sin ella, con parámetros de campaña (?utm_source=…), con los filtros y órdenes de una tienda, con cada talla o color que tiene su propia URL. Ninguna es grave mientras todas las señales apunten al mismo sitio.
| Señal | Fuerza | Cuándo usarla |
|---|---|---|
| Redirección 301 o 308 | Fuerte | Cuando la copia no tiene por qué existir: http, la versión sin www, una URL antigua |
| Etiqueta rel="canonical" | Fuerte | Cuando la copia tiene que seguir abierta: parámetros, variantes de producto, versiones para imprimir |
| Aparecer en el sitemap | Débil | Siempre, como refuerzo, y solo con URLs canónicas |
Fuente: Google, «How to specify a canonical», actualizada el 10 de julio de 2026. Pide URLs absolutas en la canónica y no usar el robots.txt para esto.
<link rel="canonical" href="https://www.tudominio.com/servicios/reformas-de-banos/">

# .htaccess (Apache): todo a https y con www en un solo salto
RewriteEngine On
RewriteCond %{HTTPS} off [OR]
RewriteCond %{HTTP_HOST} !^www\. [NC]
RewriteRule ^ https://www.tudominio.com%{REQUEST_URI} [L,R=301]
Arriba, una canónica bien escrita, con la dirección completa. Abajo, una regla de Apache que lleva cualquier variante a la versión buena con un único 301.
Lo que vimos al escribir cada dominio de cuatro formas
Probamos cada web con http y https, con www y sin ella, y seguimos las redirecciones. En 64 de las 76, las cuatro acababan en la misma dirección con redirecciones permanentes y como mucho dos saltos. En las otras doce había de todo. Ocho servían dos versiones de la portada sin redirigir (seis con la canónica apuntando a la buena, dos sin ella), tres usaban redirecciones temporales, una necesitaba tres saltos y otra tenía caducado el certificado de la versión sin www: quien escribe así la dirección se encuentra un aviso de seguridad.
Con la barra final pasó algo parecido. De 71 URLs interiores, 55 redirigían de forma permanente a su versión buena, 13 respondían de las dos maneras pero con la canónica bien puesta, dos usaban una redirección temporal y una servía las dos sin canónica. Al añadir parámetros de campaña a la portada, 70 de las 76 declaraban como canónica la URL limpia.
Arquitectura y enlazado interno: los caminos hasta cada página
Respuesta corta: Google descubre casi todo siguiendo enlaces, así que una página sin enlaces que lleguen a ella es una tienda sin calle. Una buena arquitectura deja lo importante a pocos clics de la portada y conecta entre sí las páginas que hablan de lo mismo.
- Enlaces de verdad. Google sigue con seguridad los enlaces escritos como
<a href="…">. Un botón que navega con un onclick, o un enlace sin href, puede quedarse sin rastrear. Insertarlos con JavaScript vale, siempre que acaben siendo enlaces normales. - Nada de almohadillas para cambiar el contenido. Google, en general, no tiene en cuenta lo que va detrás de # en una URL, así que una web que carga cada sección como tudominio.com/#servicios es, para él, una sola página.
- URLs que se lean. Palabras en el idioma de tu cliente separadas por guiones (no por guiones bajos) y sin largas ristras de números, como recomienda su guía de estructura de URLs.
- Poca profundidad. Si una página que vende está a cinco clics de la portada, súbela: enlázala desde el menú, desde su categoría o desde los artículos que tratan el tema.
- Cero huérfanas. Las páginas que están en el sitemap pero no reciben ningún enlace interno se encuentran cruzando las dos listas con un rastreador.
Las tiendas tienen un problema extra: los filtros. Cada combinación de talla, color, precio y orden puede generar una URL distinta, y Google avisa en su guía del presupuesto de rastreo de que las versiones de una misma página ordenadas de otra manera le hacen perder tiempo. Lo sensato es dejar indexables solo los filtros que la gente busca de verdad («zapatillas de trail para mujer») y mandar el resto a la categoría con la canónica o sacarlos del rastreo.
Un apunte de la muestra: la portada típica traía 28 enlaces internos visibles en su HTML, pero dos no tenían ninguno. En el caso de una inmobiliaria, porque su web entera depende de JavaScript, y eso nos lleva a la siguiente pieza.
JavaScript y renderizado: lo que ve Google y lo que no ve la IA
Respuesta corta: Google ejecuta JavaScript, pero en una segunda vuelta y cuando tiene recursos libres; muchos robots de IA no lo ejecutan nunca. Si el texto y los enlaces de tu web solo aparecen después de cargar scripts, Google los verá con retraso y otros robots no los verán.
Google procesa estas webs en tres fases: rastreo, renderizado e indexación. Entre la primera y la segunda, la página espera en una cola que puede durar unos segundos o bastante más, según su guía de JavaScript, actualizada el 4 de marzo de 2026. La misma guía sigue recomendando el renderizado en el servidor o el prerenderizado, porque la web va más rápida y porque no todos los robots saben ejecutar JavaScript.
Los de la IA son el mejor ejemplo. Un análisis de Vercel y MERJ publicado en diciembre de 2024 comprobó que ningún gran rastreador de IA ejecutaba JavaScript, salvo los que funcionan sobre la infraestructura de Google, como Gemini. Para ellos, tu web es el HTML que llega del servidor y punto.
En la muestra, la portada típica traía 1.126 palabras visibles en ese HTML inicial, sin ejecutar nada. Tres bajaban de 150, y la inmobiliaria del apartado anterior llegaba con cero palabras y cero enlaces: un HTML de 7 KB que solo carga la aplicación. Google puede renderizarla. Un robot que no ejecute JavaScript se encuentra una página en blanco.
Cómo comprobarlo y qué hacer
- Abre el código fuente de una página (el código fuente, no el inspector) y busca una frase del texto. Si no aparece, ese texto depende de JavaScript.
- En Search Console, la inspección de URLs enseña el HTML que Google ha renderizado y los recursos que no pudo cargar.
- Si la web está hecha con React, Vue o Angular, pide renderizado en el servidor o generación estática; herramientas como Next.js, Nuxt o Astro lo traen de serie.
- En una web de una sola página, cada vista necesita su propia URL con la API History, y las páginas de error tienen que responder 404 o llevar noindex, como pide Google para evitar soft 404.
Velocidad, Core Web Vitals y móvil
Respuesta corta: Google mide la experiencia de carga con tres métricas y las usa en su ranking, aunque no como un interruptor: una página lenta que responde mejor a la búsqueda puede ganar a una rápida que no. Lo innegociable es el móvil, porque Google indexa la versión móvil de tu web.
| Métrica | Umbral bueno | Causas habituales | Arreglo habitual |
|---|---|---|---|
| LCP: cuánto tarda en verse lo principal | 2,5 s o menos | Foto principal pesada o con carga diferida, servidor lento, CSS que bloquea | WebP o AVIF a su tamaño, sin carga diferida en la primera imagen, caché y CDN |
| INP: cuánto tarda en reaccionar al tocar | 200 ms o menos | Exceso de JavaScript: chats, píxeles y gestores de etiquetas que acaparan el navegador | Quitar scripts que no se usan, cargar los de terceros más tarde, trocear el código |
| CLS: cuánto se mueve mientras carga | 0,1 o menos | Imágenes sin dimensiones, banners y avisos de cookies que empujan el texto, fuentes web | Ancho y alto en imágenes y vídeos, hueco reservado para banners, font-display en las fuentes |
Umbrales: web.dev, «Web Vitals», actualizada el 31 de octubre de 2024, en el percentil 75 de las visitas. Causas y arreglos: los más frecuentes, a modo de orientación.
Sobre su peso real, la página de experiencia de Google (actualizada el 22 de septiembre de 2026) es bastante clara. Las Core Web Vitals sí las usan sus sistemas de ranking, no existe una única «señal de experiencia de página» y el resto de aspectos no te sube directamente. Añade que perseguir la nota perfecta solo por SEO quizá no sea el mejor uso de tu tiempo. Traducido: arregla lo que suspende y dedica el resto del esfuerzo a otra cosa.
Móvil primero, de verdad
Google rastrea e indexa con su robot para smartphone. Si tu versión móvil enseña menos texto, menos enlaces o menos datos estructurados que la de ordenador, lo que falte en el móvil no cuenta. Su guía pide además las mismas etiquetas meta robots en las dos versiones y no esconder el contenido principal detrás de un toque para cargarlo. Con un diseño adaptable, el mismo HTML para todas las pantallas, casi todo esto viene resuelto: 75 de las 76 webs de la muestra tenían la etiqueta viewport que lo hace posible.
Una advertencia honesta: no medimos las Core Web Vitals de la muestra, porque la API de PageSpeed Insights no tenía cuota ese día. Solo medimos cuánto tardaba el servidor en empezar a responder la portada: una mediana de 250 milisegundos y ninguna por encima de 1,6 segundos, en una sola medición. Para tu web, usa PageSpeed Insights en la pestaña del móvil y el informe de Core Web Vitals de Search Console.
HTTPS y certificados: que el candado no caduque
Respuesta corta: sirve toda la web por HTTPS, redirige cualquier dirección http a su equivalente segura con un 301 y vigila la caducidad del certificado. Google pregunta si tus páginas se sirven de forma segura en su lista de experiencia de página y ofrece un informe HTTPS en Search Console para comprobarlo.
En la muestra, todas funcionaban con HTTPS, pero no siempre bien rematado. Una seguía sirviendo la versión http sin redirigir, otra tenía caducado el certificado de la variante sin www y tres cargaban algún recurso por http dentro de páginas seguras, lo que se llama contenido mixto y el navegador bloquea o marca. Solo 29 de 76 enviaban la cabecera HSTS, que obliga al navegador a usar siempre la versión segura. No es un requisito de Google, pero cierra la puerta a esa primera visita por http.
Si todavía tienes pendiente el paso de http a https, trátalo como lo que es para Google, un cambio de URLs: mapa de redirecciones 301, canónicas y enlaces internos con la dirección nueva y un sitemap actualizado.
Datos estructurados y hreflang: etiquetas que solo leen las máquinas
Respuesta corta: los datos estructurados describen la página con el vocabulario de schema.org para que el buscador entienda qué es cada cosa, y el hreflang le dice qué versión corresponde a cada idioma o país. Los dos se rompen sin que se note a simple vista.
Los datos estructurados tienen su propia guía, con código para copiar: datos estructurados por tipo de negocio. La parte técnica se resume en tres reglas. JSON-LD mejor que microdatos, que coincidan con lo que se ve en la página y volver a validarlos después de cada cambio de plantilla, porque un rediseño puede borrarlos sin avisar a nadie.
hreflang: las reglas que más se saltan
- Cada versión se enlaza a sí misma y a todas las demás. Si la página en inglés apunta a la española y la española no le devuelve el enlace, Google ignora las dos etiquetas.
- Idioma en ISO 639-1 y, si quieres, país en ISO 3166-1: es-ES, en-GB, ca-ES. «en-UK» no existe. Y si vendes en Latinoamérica, ojo: Google no admite es-419.
- El país solo no vale. El primer código siempre es el idioma, y «ES» a secas no le dice nada.
- x-default para el resto del mundo, sobre todo si la portada tiene un selector de idioma o redirige según el navegador.
- Las URLs del hreflang tienen que ser las definitivas y completas, con https y dominio. Google pide la dirección entera de cada versión, y una que redirige le obliga a dar un salto más para encontrar la página.
<link rel="alternate" hreflang="es-ES" href="https://www.tudominio.com/">
<link rel="alternate" hreflang="en-GB" href="https://www.tudominio.com/en/">
<link rel="alternate" hreflang="ca-ES" href="https://www.tudominio.com/ca/">
<link rel="alternate" hreflang="x-default" href="https://www.tudominio.com/">
El mismo bloque, idéntico, va en las tres versiones de la página. Fuente de las reglas: Google, «Localized versions of your pages», actualizada el 21 de septiembre de 2026.
En la muestra, 27 de las 76 webs declaraban hreflang en la portada, y lo básico lo cumplían todas: cada una se incluía a sí misma y, de las 52 versiones alternativas que abrimos, las 47 que respondían 200 devolvían el enlace. Los fallos fueron más finos. Tres webs apuntaban a URLs que redirigen (una tienda declara 134 combinaciones de idioma y país, y las tres que abrimos redirigían) y diez no tenían x-default, que no es obligatorio pero evita sorpresas. Si vendes fuera, lo vemos con calma en SEO internacional.
Rastreadores de IA: la parte nueva del SEO técnico
Respuesta corta: los asistentes de IA tienen sus propios robots, con nombres distintos para buscar y para entrenar. El SEO técnico de 2026 incluye decidir a cuáles dejas pasar y comprobar que nadie los bloquea sin querer.
- OAI-SearchBot (OpenAI)
- El de la búsqueda de ChatGPT. Si lo bloqueas, tu web no sale en sus respuestas con búsqueda, aunque pueda aparecer como enlace de navegación. OpenAI calcula unas 24 horas para que un cambio en el robots.txt haga efecto.
- GPTBot (OpenAI)
- El del entrenamiento de sus modelos. Se controla por separado: puedes cerrarle la puerta y seguir abierto a la búsqueda.
- Google-Extended
- No es un robot sino una etiqueta del robots.txt. Decide si Google puede usar tu contenido para entrenar Gemini y para fundamentar las respuestas de la app de Gemini y de Vertex AI. Google repite que no afecta a tu presencia ni a tu posición en el buscador.
Un dato reciente que conviene apuntar: en su página de rastreadores, actualizada el 30 de octubre de 2026, Google anuncia que piensa admitir a principios de 2027 AIPREF, una señal común en el robots.txt para indicar si permites el entrenamiento de IA. Si llega, será una línea más en el mismo archivo.
En la muestra no hubo sustos aquí: ninguna de las 76 webs bloqueaba a OAI-SearchBot ni cerraba la raíz en el robots.txt. El archivo, eso sí, no es lo único que manda. Los cortafuegos y las CDN pueden frenar a estos robots aunque el robots.txt los deje pasar, y eso no se ve leyendo el fichero. El comprobador de rastreadores de IA de Slibur.com te dice en un momento qué robots tienen la puerta abierta, y la lista completa de agentes, con los de Anthropic y Perplexity, está en nuestra guía de llms.txt y robots de IA.
Problemas de SEO técnico más comunes: cómo detectarlos y arreglarlos
Esta es la tabla para tener a mano. Están los fallos que más vemos, los que salieron en la muestra y los que Google cita en su documentación, con la forma rápida de detectarlos y el arreglo.
| Problema | Cómo lo detectas | Cómo se arregla |
|---|---|---|
| Noindex olvidado al publicar la web | Search Console, Páginas: «Excluida por la etiqueta noindex»; código fuente | Quitarlo en el plugin SEO o desmarcar «Disuadir a los motores de búsqueda» en WordPress |
| robots.txt con «Disallow: /» de cuando la web estaba en obras | Abrir tudominio.com/robots.txt | Borrar la línea y proteger el entorno de pruebas con contraseña |
| robots.txt que da error de servidor | Pestaña Red del navegador; informe de robots.txt en Search Console | Que el servidor lo entregue siempre, aunque sea vacío, o que responda 404 |
| Soft 404 | Visitar una URL inventada; informe Páginas | Responder 404 o 410 de verdad y no mandar lo que no existe a la portada |
| Varias versiones de la portada | Escribir el dominio de las cuatro formas | Un 301 de cada variante a la buena, en un solo salto |
| Redirecciones en cadena o temporales | Un rastreador o un comprobador de cabeceras | Cada URL vieja, directa al destino final con 301 |
| Canónica ausente o equivocada | Código fuente; la inspección de URLs muestra la canónica que eligió Google | Canónica absoluta hacia sí misma en cada página indexable |
| Sitemap con redirecciones, 404 o noindex | Informe Sitemaps y un rastreo del propio sitemap | Generarlo solo con URLs canónicas que respondan 200 |
| Páginas de ejemplo publicadas («Hola mundo») | Buscar site:tudominio.com en Google y repasar el sitemap | Borrarlas con 404 o 410, o redirigirlas si tienen enlaces |
| Texto que solo aparece con JavaScript | Código fuente o inspección de URLs | Renderizado en el servidor o prerenderizado |
| hreflang sin enlace de vuelta o hacia URLs que redirigen | Abrir cada versión; informe de hreflang de un rastreador | Lista completa y recíproca en todas las versiones, con las URLs finales |
| Contenido mixto o certificado caducado | Aviso del navegador; informe HTTPS de Search Console | Todo por https y renovación automática del certificado |
| LCP o INP en rojo en el móvil | PageSpeed Insights, pestaña del móvil | Comprimir y dimensionar imágenes, retrasar los scripts que no hacen falta al cargar |
Elaborada por Vértigo Marketing con la documentación de Google Search Central y los fallos medidos el 7 de noviembre de 2026.
Un consejo de orden: empieza por lo que te deja fuera (noindex, robots.txt, errores de servidor), sigue por lo que confunde a Google sobre cuál es la URL buena (canónicas, variantes, sitemap) y deja para el final lo que pule (velocidad fina, x-default, HSTS). Es el mismo criterio que usaría un médico de urgencias, salvando las distancias.
Trece comprobaciones en 76 webs: dónde falla el SEO técnico de las pymes
Para saber qué falla de verdad, pasamos trece comprobaciones técnicas por las webs de 16 empresas B2B, 15 tiendas online, 13 clínicas dentales, 11 despachos de abogados, 11 restaurantes, 7 inmobiliarias y 3 negocios de servicios locales. Todas salieron citadas por ChatGPT en las pruebas anteriores del blog, así que son webs que la IA ya usa como fuente, y ninguna repite de las diez de la guía de auditoría. Partimos de 85: dos dominios ya no existían, una portada daba 404, otra redirigía a la web de otra marca y cinco no respondieron o cortaron nuestras peticiones.
Las peticiones fueron normales, como las de un navegador que no ejecuta JavaScript. Por cada web leímos las cuatro variantes del dominio, la portada (también con parámetros de campaña), el robots.txt, una URL inventada, hasta doce URLs repartidas por el sitemap, una URL interior con y sin barra final y, si había hreflang, hasta tres versiones de idioma.
Prueba propia hecha el 7 de noviembre de 2026. Las respuestas de la IA cambian con el tiempo: si repites la pregunta puede salirte otra cosa.
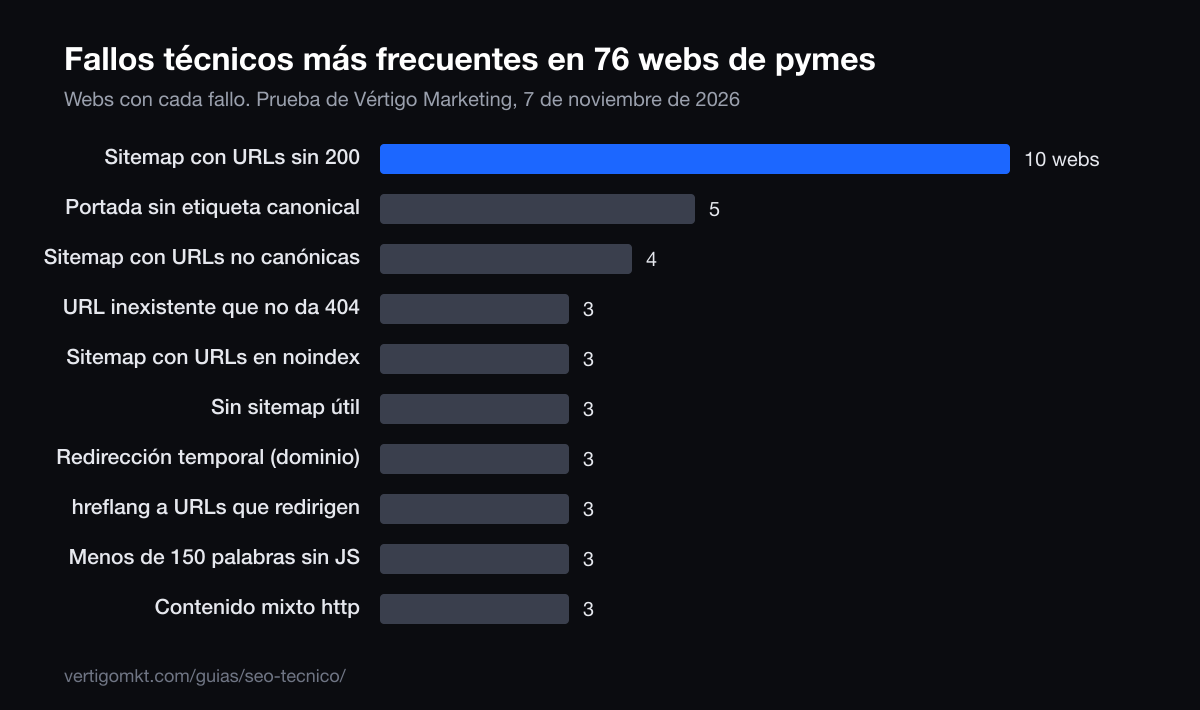
Resultado: 30 de las 76 webs tienen al menos un fallo técnico de los que señala la documentación de Google, y 46 pasan todas las comprobaciones. Lo que mejor está es lo que viene de serie. Ninguna bloquea a Google ni a los robots de IA en su robots.txt, 72 responden bien a una página que no existe y 75 están preparadas para el móvil. Lo que peor está es lo que nadie revisa después de publicar, que es el sitemap.
Tiene explicación. El sitemap lo genera casi siempre un plugin (47 de las 76 webs usan WordPress), y el plugin mete lo que encuentra: entradas de ejemplo, páginas legales con noindex, productos retirados que redirigen a su categoría, variantes con la canónica en otra URL. Ninguno de esos fallos hunde una web por sí solo, pero todos hacen lo mismo: dan a Google señales que se contradicen y le hacen gastar visitas en direcciones que no quieres ver en el buscador.
Y lo que la prueba no dice. La muestra es pequeña y está sesgada hacia webs que funcionan, porque la IA ya las cita. Es una foto de un día, sin rastrear ninguna web entera ni medir la velocidad real. Tampoco esos fallos impidieron que ChatGPT las citara: el SEO técnico no te hace recomendable, pero evita que pierdas por el camino lo que ya te has ganado.
Herramientas para revisar el SEO técnico y cada cuánto hacerlo
- Google Search Console
- Gratis y del propio Google: informe Páginas, inspección de URLs, Sitemaps, Estadísticas de rastreo (en Ajustes), Core Web Vitals y HTTPS. Si solo vas a usar una herramienta, que sea esta.
- PageSpeed Insights
- Core Web Vitals con datos reales de Chrome cuando tu web tiene visitas suficientes, más una prueba de laboratorio para encontrar qué frena.
- Un rastreador
- Recorre la web como lo haría un buscador y saca redirecciones, canónicas, hreflang y páginas huérfanas. Screaming Frog es gratis hasta 500 URLs, suficiente para muchas pymes.
- Los registros del servidor
- Cuentan qué robots pasan de verdad, cada cuánto y qué códigos reciben. En una web grande son la fuente más fiable de todas.
- El propio navegador
- El código fuente, la pestaña Red de las herramientas de desarrollo y escribir direcciones a mano resuelven la mitad de las dudas sin instalar nada.
Cada cuánto: un vistazo mensual a Search Console (Páginas, Core Web Vitals y Estadísticas de rastreo) para cazar sustos a tiempo, una revisión técnica completa al año y otra siempre antes y después de cualquier cambio gordo: rediseño, plantilla nueva, cambio de plugin SEO, de hosting o de dominio. Es ahí donde se rompen las cosas, y un cambio de dominio o de plataforma merece tratarse como una migración en toda regla.
Si prefieres que lo mire alguien con oficio, en Vértigo Marketing el mismo equipo hace SEO, GEO, SEM, diseño web y software a medida desde nuestra oficina de Murcia. Trabajamos para más de 200 clientes y tenemos un 5,0 en Google con 34 reseñas. Lo que incluye nuestra revisión técnica lo contamos en auditoría SEO, y la primera mirada a tu caso es gratis.
En Vértigo Marketing trabajamos el GEO y el SEO de empresas de toda España: miramos qué responden ChatGPT y Google sobre tu sector, en qué fuentes se apoyan y qué falta para que te nombren. Pide tu revisión gratis
Preguntas frecuentes
¿Qué es el SEO técnico?
Es la parte del SEO que se asegura de que los buscadores y los robots de IA puedan rastrear, entender e indexar una web: códigos de respuesta, robots.txt, sitemap, redirecciones, canónicas, JavaScript, velocidad, versión móvil, HTTPS, datos estructurados y hreflang. No sustituye al contenido ni a los enlaces, pero sin esa base ninguno de los dos rinde.
¿Qué diferencia hay entre SEO técnico y SEO on page?
El SEO técnico trabaja la infraestructura: que Google llegue, lea y guarde la versión correcta de cada página. El SEO on page trabaja cada página por dentro: el tema, el título, los encabezados y el texto que responde a la búsqueda. Se solapan en cosas como las canónicas o los datos estructurados.
¿Cuáles son los errores técnicos de SEO más frecuentes?
En nuestra prueba de noviembre de 2026 con 76 webs de pymes, el más repetido fue tener en el sitemap URLs que no responden 200 (10 webs), seguido de portadas sin etiqueta canonical (5) y de sitemaps con URLs que no son la versión canónica (4). También salieron soft 404, redirecciones temporales, hreflang hacia URLs que redirigen y contenido mixto.
¿Necesito saber programar para hacer SEO técnico?
Para revisarlo, no: con Search Console, PageSpeed Insights, el código fuente del navegador y un rastreador se detecta casi todo. Para arreglar algunas cosas sí hace falta tocar el servidor, la plantilla o el código, como las redirecciones, el renderizado de JavaScript o la velocidad. Ahí conviene contar con quien hizo la web o con un equipo técnico.
¿El SEO técnico influye en ChatGPT y en la IA?
Sí, en lo básico. Si el robots.txt o el cortafuegos bloquean a OAI-SearchBot, tu web no sale en las respuestas con búsqueda de ChatGPT, según OpenAI. Y como los grandes rastreadores de IA no ejecutan JavaScript, el texto tiene que estar en el HTML que entrega el servidor. Lo técnico abre la puerta; que te citen depende del contenido y de lo que digan otros de ti.
¿Cada cuánto hay que revisar el SEO técnico?
Un vistazo mensual a Search Console, una revisión completa al año y una más antes y después de cualquier cambio grande: rediseño, plantilla, plugin SEO, hosting o dominio. En tiendas y webs grandes, con miles de URLs que cambian, la revisión tiene que ser continua.
¿Qué herramientas gratis sirven para el SEO técnico?
Google Search Console para indexación, sitemaps, rastreo y HTTPS; PageSpeed Insights para las Core Web Vitals; la prueba de resultados enriquecidos de Google para los datos estructurados; la versión gratuita de Screaming Frog, hasta 500 URLs, para rastrear la web, y el comprobador de rastreadores de IA de Slibur.com para los robots de la IA.
Sigue leyendo
- Cómo hacer una auditoría SEO (y la parte GEO) paso a paso
- Datos estructurados y schema markup: código por tipo de negocio, validación y papel en la IA
- Archivo llms.txt y robots de IA: ejemplo para copiar y datos de 34 webs españolas
- Diferencia entre SEO y SEM: qué es cada uno, cuándo conviene y cómo sumarlos
- Agencia GEO en España: posicionamiento en ChatGPT y en Google
- Las mejores agencias GEO de España
Fuentes
Las cifras y afirmaciones de esta guía salen de estas fuentes:
- Google Search Central: «In-depth guide to how Google Search works» (actualizada el 18-12-2025)
- Google: «How HTTP status codes affect Google's crawlers» (actualizada el 04-02-2026)
- Google: «How Google interprets the robots.txt specification» (actualizada el 23-10-2026)
- Google: «Crawl budget management» (actualizada el 22-07-2026)
- Google Search Central: «How to specify a canonical» (actualizada el 10-07-2026)
- Google Search Central: «Understand JavaScript SEO basics» (actualizada el 04-03-2026)
- Google Search Central: «Understanding page experience» (actualizada el 22-09-2026)
- Google Search Central: «Mobile-first indexing best practices» (actualizada el 10-12-2025)
- Google Search Central: «Localized versions of your pages» (actualizada el 21-09-2026)
- Google: «Google's common crawlers» (actualizada el 30-10-2026)
- OpenAI: rastreadores y user agents
- web.dev: «Web Vitals» (actualizada el 31-10-2024)
- Vercel: «The rise of the AI crawler» (17-12-2024)
Por el equipo de Vértigo Marketing Publicado el Revisado el