Archivo llms.txt y robots de IA: ejemplo para copiar y datos de 34 webs españolas
El llms.txt es un archivo de texto en Markdown que se sube a la raíz de la web con un resumen y los enlaces más útiles, para que los modelos de lenguaje entiendan el sitio de un vistazo. Lo propuso Jeremy Howard en 2024. Es opcional: Google dice que su buscador lo ignora, y quien decide qué robots de IA entran sigue siendo el robots.txt.
Cada pocos años aparece un archivo que promete arreglarle la vida a tu web. En 2026 le toca al llms.txt, y la mitad de lo que se lee sobre él es humo: ni te sube en Google ni obliga a ChatGPT a citarte. La otra mitad sí merece la pena, sobre todo la parte que casi nadie cuenta, que es el robots.txt y la lista de robots de IA que llaman a tu puerta cada día.
Aquí tienes las dos cosas: qué es el archivo, un ejemplo para copiar, cómo subirlo y qué no hace según Google, y después quién es quién entre los rastreadores de IA, con un robots.txt de ejemplo. Para aterrizarlo, el 27 de octubre de 2026 revisamos con un script qué hacen 34 webs españolas conocidas.
Qué es el llms.txt y de dónde sale
Respuesta corta: es un índice de tu web escrito para máquinas. Un archivo de texto llamado llms.txt, en la raíz del dominio, con el nombre del sitio, dos líneas que explican qué es y una lista de enlaces a las páginas que importan, cada una con una nota breve.
La idea la publicó Jeremy Howard en llmstxt.org el 3 de septiembre de 2024. El problema que quería resolver es real: una página web normal viene cargada de menús, banners, scripts y cookies, y a un modelo de lenguaje le cuesta separar el contenido de la paja. Además, la mayoría de webs no caben enteras en la ventana de contexto de un modelo. Un archivo corto, limpio y en Markdown le ahorra trabajo.
La propuesta incluye una segunda parte que se cita menos: ofrecer una versión en Markdown de cada página importante, en la misma dirección con .md al final (pagina.html.md o pagina.md). Así, quien lea el índice puede saltar directamente a una versión sin ruido.
Quién lo usa de verdad
Sobre todo la documentación técnica. Comprobamos que publican el suyo la de Anthropic, la de Stripe, la de Cloudflare y la de OpenAI. Tiene lógica: quien programa con un asistente de IA le pide que lea la documentación, y un índice limpio ayuda. Fuera de ese mundo, la adopción es mucho más escasa, como verás en los datos de España más abajo.
Formato del archivo, con un ejemplo listo para copiar
Respuesta corta: un título con el nombre del sitio, una cita con el resumen y varias secciones con listas de enlaces. Solo el título es obligatorio. Todo va en Markdown, el formato de almohadillas y guiones que se usa para escribir texto con estructura sin HTML.
Este sería el de una clínica dental inventada de Murcia. Cambia los nombres, las direcciones y las notas por los tuyos y te vale para cualquier negocio:
# Clínica Dental Ejemplo

> Clínica dental en Murcia con implantes, ortodoncia invisible y odontopediatría.
> Abierta de lunes a viernes de 9:00 a 21:00. Primera visita sin coste.

Atendemos en español e inglés y trabajamos con los principales seguros dentales.

## Servicios

- [Implantes dentales](https://www.tudominio.es/implantes/): tipos, plazos, garantía y preguntas frecuentes
- [Ortodoncia invisible](https://www.tudominio.es/ortodoncia-invisible/): cómo funciona y cuánto dura
- [Odontopediatría](https://www.tudominio.es/ninos/): primera visita, edades y prevención

## La clínica

- [Equipo](https://www.tudominio.es/equipo/): dentistas, especialidades y número de colegiado
- [Horario y cómo llegar](https://www.tudominio.es/contacto/): dirección, aparcamiento y teléfono
- [Opiniones de pacientes](https://www.tudominio.es/opiniones/)

## Optional

- [Blog](https://www.tudominio.es/blog/): artículos sobre salud bucodental
- [Aviso legal](https://www.tudominio.es/aviso-legal/)
Ejemplo de llms.txt para un negocio local. La sección Optional se queda en inglés porque así la llama la propuesta.
| Pieza | Cómo se escribe | ¿Obligatoria? | Para qué sirve |
|---|---|---|---|
| Título | # Nombre del sitio | Sí, la única | Dice de quién es el archivo |
| Resumen | > Una o dos frases | No | Lo esencial: qué haces, dónde y para quién |
| Texto libre | Párrafos o listas sin títulos | No | Detalles que ayudan a entender el resto |
| Secciones | ## Nombre de la sección | No | Agrupan los enlaces por temas |
| Enlaces | - [Nombre](url): nota | Dentro de cada sección | Las páginas a leer, con una pista de qué contienen |
| Optional | ## Optional | No | Lo secundario, que un modelo puede saltarse si va justo de espacio |
Fuente: especificación publicada en llmstxt.org, consultada el 27 de octubre de 2026.
Tres consejos que no vienen en la especificación pero se agradecen. Escribe las notas como si se las contaras a un cliente por teléfono: «tipos, plazos y garantía» dice más que «más información». Enlaza solo páginas que respondan con un 200 y que existan de verdad. Y no metas palabras clave a granel: el archivo lo lee una máquina que entiende frases, no un buscador de 2005.
¿Y el llms-full.txt?
Es una variante que se ha hecho popular: un único archivo con todo el contenido del sitio en Markdown, en lugar de un índice con enlaces. No aparece en la propuesta original. Tiene sentido para documentación técnica, donde alguien quiere pasarle el manual entero a su asistente; para una pyme con veinte páginas, el índice basta.
Cómo crear el archivo y subirlo a tu web en cinco pasos
Respuesta corta: se escribe en cualquier editor de texto, se guarda como llms.txt en UTF-8 y se sube a la carpeta principal del dominio, la misma donde está tu robots.txt. Con WordPress hay atajos.
- Elige las páginas. Entre diez y treinta: servicios o categorías principales, quiénes sois, contacto, precios si los publicas y las guías que mejor responden a tus clientes.
- Escribe el archivo siguiendo el ejemplo de arriba. El Bloc de notas o TextEdit en modo texto plano sirven; Word no, porque mete formato invisible.
- Súbelo a la raíz por FTP o con el gestor de archivos de tu hosting, de modo que quede en tudominio.es/llms.txt y no dentro de una subcarpeta.
- Compruébalo en el navegador. Tiene que verse como texto plano. Si sale tu página de inicio o un error con diseño, el servidor no está entregando el archivo.
- Revísalo cada pocos meses, o cuando cambies servicios o direcciones. Un índice con enlaces rotos es peor que no tener índice.
Si tu web va con WordPress, Yoast SEO lo genera desde la versión 25.3 de junio de 2025 (Ajustes, Funciones del sitio, apartado de herramientas de IA) y Rank Math tiene un módulo llamado LLMS Txt que se activa desde su panel. Si prefieres partir de un borrador hecho, el generador gratuito de llms.txt de Slibur.com crea uno a partir de tu sitemap y tu portada, listo para editar y descargar.
Un detalle curioso: Lighthouse, la herramienta de auditoría de Chrome, ya incluye una comprobación del archivo en su categoría dedicada a la navegación con agentes de IA. Si no lo tienes, la marca como «no aplicable», no como fallo. Solo protesta si el servidor da error al pedirlo.
Lo que el llms.txt no hace (y lo que dice Google por escrito)
Respuesta corta: no mejora tu posicionamiento en Google, no sale en los AI Overviews por tenerlo y no obliga a ningún asistente a leerlo. Es una invitación, no una palanca.
Google lo dejó claro en su guía para optimizar la web para las funciones de IA generativa, publicada el 15 de mayo de 2026 y actualizada el 10 de julio de 2026. En el apartado de mitos explica que no hace falta crear archivos para máquinas, archivos de texto para IA, marcado nuevo ni versiones en Markdown para aparecer en el buscador, tampoco en sus respuestas con IA, porque, cita literal, «Google Search itself doesn't use them» (el buscador de Google no los usa).
El 15 de junio de 2026 añadió una aclaración, recogida en su registro de cambios: tener estos archivos no te ayuda ni te perjudica en visibilidad ni en posiciones, y no pasa nada si los mantienes para otros servicios que sí los lean. Que Google rastree el archivo, como rastrea cualquier otro, no significa que lo trate de forma especial.
¿Y los demás? En sus páginas oficiales sobre robots, OpenAI, Anthropic y Perplexity explican qué rastreadores usan y cómo bloquearlos, pero no dicen que lean el llms.txt de las webs que visitan. Lo gracioso es que la documentación de OpenAI y la de Perplexity sí enlazan a su propio llms.txt, pensado para los asistentes de programación.
| Lo que se oye | Lo que hay |
|---|---|
| «Te sube en Google» | Google dice que su buscador lo ignora y que no ayuda ni perjudica |
| «Hace que ChatGPT te cite» | OpenAI no dice en su documentación de robots que lo use; para su búsqueda cuenta OAI-SearchBot |
| «Protege tu contenido de la IA» | No bloquea nada; eso se hace en el robots.txt |
| «Es un estándar oficial» | Es una propuesta de 2024; Rank Math la describe como propuesta, no como estándar |
| «No sirve para nada» | Ordena tu web para agentes y herramientas que sí lo leen, y cuesta una tarde |
Fuentes: Google Search Central (guía de IA generativa, actualizada el 10-07-2026), OpenAI y la base de conocimiento de Rank Math, consultadas el 27 de octubre de 2026.
Si tu objetivo es aparecer en el Modo IA de Google o en los AI Overviews, el trabajo está en otro sitio: que Googlebot pueda rastrear, contenido que responda mejor que el de la competencia, ficha de empresa cuidada y menciones fuera de tu web. Lo tienes paso a paso en la guía de SEO para IA.
Rastreadores de IA: quién es quién y qué pasa si los bloqueas
Respuesta corta: hay tres familias. Los que entrenan modelos, los que buscan para responder en tiempo real y los que visitan una página porque un usuario lo ha pedido. Bloquear a los primeros no te saca de las respuestas; bloquear a los segundos, sí.
| Nombre en robots.txt | Empresa | Familia | Si lo cierras |
|---|---|---|---|
| GPTBot | OpenAI | Entrenamiento | Tu contenido no se usa para entrenar sus modelos; ChatGPT puede seguir citándote |
| OAI-SearchBot | OpenAI | Búsqueda | Desapareces de las respuestas con búsqueda de ChatGPT (salvo enlaces de navegación) |
| ChatGPT-User | OpenAI | Visita a petición | OpenAI avisa de que robots.txt puede no aplicarse, porque la pide una persona |
| ClaudeBot | Anthropic | Entrenamiento | Tus páginas futuras quedan fuera del entrenamiento |
| Claude-SearchBot | Anthropic | Búsqueda | Claude deja de indexarte para sus respuestas con búsqueda |
| Claude-User | Anthropic | Visita a petición | Claude no puede abrir tu página cuando un usuario se lo pide |
| PerplexityBot | Perplexity | Búsqueda | No apareces en sus resultados; Perplexity dice que no lo usa para entrenar |
| Perplexity-User | Perplexity | Visita a petición | Por lo general ignora robots.txt, según la propia Perplexity |
| Google-Extended | Entrenamiento y grounding | Gemini no entrena con tu web ni la usa para apoyar respuestas en su app; Google Search no cambia | |
| Applebot-Extended | Apple | Entrenamiento | No rastrea nada: solo decide si Apple entrena con lo que ya recogió Applebot |
| Meta-ExternalAgent | Meta | Entrenamiento e indexación | Meta no rastrea tu web para entrenar sus modelos ni para indexarla en sus productos |
| CCBot | Common Crawl | Archivo abierto de la web | Tu web queda fuera de su archivo público |
Fuentes: documentación de OpenAI, Anthropic, Perplexity, Google, Apple, Meta y Common Crawl, consultada el 27 de octubre de 2026.
Dos casos merecen una explicación aparte. El primero es Google. Los AI Overviews y el Modo IA usan Googlebot, el mismo robot del buscador, así que no puedes cerrarles el paso con robots.txt sin desaparecer de Google entero. Para eso, desde el 31 de agosto de 2026 Search Console tiene en sus ajustes un control de IA generativa para todas las webs del mundo: si eliges excluir tu sitio, sales de los AI Overviews, del Modo IA y de las funciones con IA de Discover en uno o dos días, sin tocar tus posiciones en los resultados normales.
El segundo es Google-Extended, que mucha gente bloquea pensando que solo afecta al entrenamiento. Según Google, también decide si su contenido sirve para el grounding (apoyar las respuestas con fuentes) en la app de Gemini y en Vertex AI. Si te interesa que la app de Gemini se base en tu web al contestar, piénsatelo antes de cerrarlo.
Por último, un recordatorio poco popular: robots.txt es una petición, no un candado. Las empresas serias la respetan, y los robots que actúan en nombre de un usuario avisan de que pueden saltársela. Anthropic añade que bloquear sus direcciones IP puede ser contraproducente, porque entonces sus robots ni siquiera pueden leer tu robots.txt para saber qué no quieres.
Un robots.txt para que la IA te cite sin entrenar con tu web
Respuesta corta: abre la puerta a los robots de búsqueda y a las visitas de usuarios, ciérrasela a los de entrenamiento y deja el resto como estaba. Este es el bloque, con la sintaxis de grupos que admiten todos los rastreadores grandes:
# Que la IA me encuentre y me cite...
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
Allow: /
Disallow: /carrito/
Disallow: /mi-cuenta/

# ...pero sin usar mi web para entrenar modelos
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Applebot-Extended
User-agent: Meta-ExternalAgent
User-agent: CCBot
Disallow: /

# Opcional: entrenamiento de Gemini y apoyo a sus respuestas en la app
# User-agent: Google-Extended
# Disallow: /

# El resto de robots, Googlebot incluido
User-agent: *
Disallow: /carrito/
Disallow: /mi-cuenta/

Sitemap: https://www.tudominio.es/sitemap.xml
robots.txt de ejemplo. Cambia las rutas privadas (aquí, carrito y cuenta) por las tuyas en los dos grupos donde aparecen y quita el comentario de Google-Extended solo si aceptas salir del apoyo de la app de Gemini.
- Un robot solo obedece a su grupo. Si GPTBot tiene un grupo propio, ignora lo que pongas bajo «User-agent: *». Por eso, si en el grupo general tienes rutas privadas, cópialas también en los grupos con nombre.
- Los cambios no son instantáneos. OpenAI y Perplexity hablan de unas 24 horas; Meta guarda en caché tu robots.txt hasta un día.
- Cada subdominio tiene el suyo. tienda.tudominio.es no hereda las reglas de www.tudominio.es.
- Revisa el cortafuegos. Si tu hosting o Cloudflare bloquean a estos robots antes de llegar a la web, da igual lo que diga el robots.txt.
Para comprobar en un minuto qué robots estás dejando fuera sin leer el archivo línea a línea, el comprobador de rastreadores de IA de Slibur.com lo hace gratis. Y si quieres verificar que un visitante que dice ser GPTBot lo es de verdad, OpenAI y Perplexity publican las direcciones IP desde las que rastrean.
Prueba: qué hacen 34 webs españolas con el llms.txt y los robots de IA
Respuesta corta: el índice para IA todavía es cosa de pocos (7 de 34) y los bloqueos a la IA son, sobre todo, cosa de los periódicos. Ninguno de los cinco bancos cuyo robots.txt pudimos leer cierra la puerta a los rastreadores de IA.
El método: el 27 de octubre de 2026 pedimos con un script /llms.txt, /llms-full.txt y /robots.txt a 34 webs muy visitadas en España (10 medios, 10 tiendas y portales, 6 bancos y 8 administraciones) y leímos las reglas que aplican a cada uno de los doce robots de la tabla anterior. Contamos un robot como «bloqueado» cuando tiene prohibida la portada. Dos webs no nos dejaron leer el robots.txt por su protección contra bots, así que el recuento de robots va sobre 32.
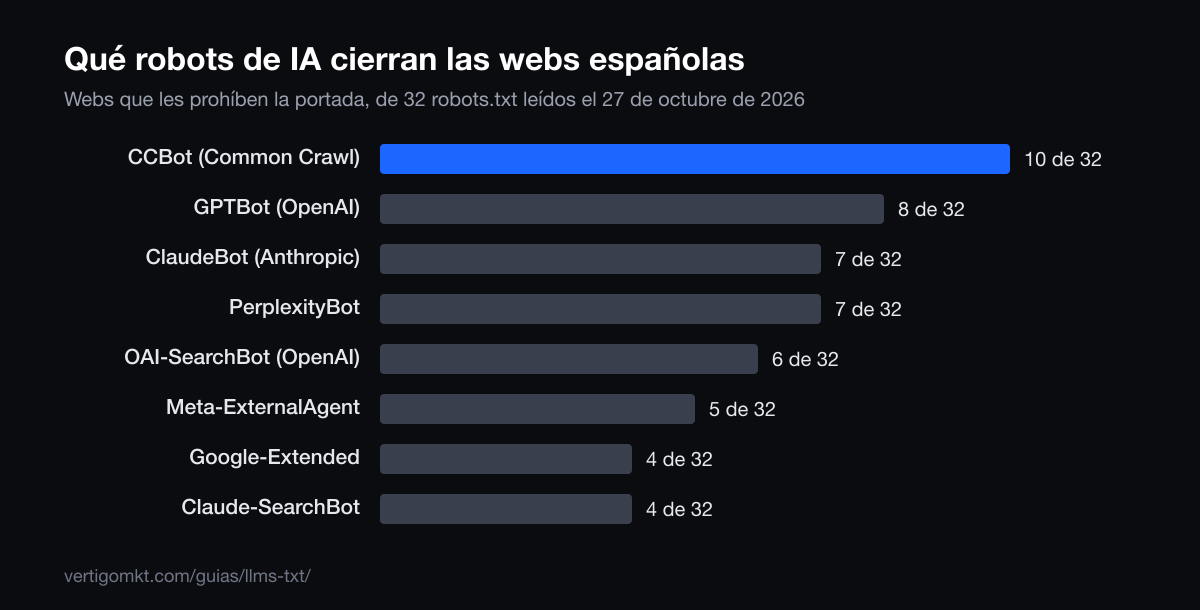
Prueba propia hecha el 27 de octubre de 2026. Las respuestas de la IA cambian con el tiempo: si repites la pregunta puede salirte otra cosa.
| Tipo de web | Webs | Con llms.txt válido | Bloquean algún robot de IA |
|---|---|---|---|
| Medios | 10 | 1 (La Vanguardia) | 8 de 10 |
| Tiendas y portales | 10 | 3 (El Corte Inglés, MediaMarkt, PcComponentes) | 1 de 9 (Wallapop, solo CCBot) |
| Bancos | 6 | 2 (BBVA, Banco Sabadell) | 0 de 5 |
| Administraciones | 8 | 1 (Ayuntamiento de Madrid) | 1 de 8 (SEPE) |
| Total | 34 | 7 | 10 de 32 |
Fuente: prueba propia de Vértigo, 27 de octubre de 2026. «Válido» = responde 200, no es una página HTML y empieza por un título en Markdown. Datos completos en el archivo de la prueba.
Lo que más nos llamó la atención
- El índice es minoritario. 7 de 34 servían un archivo válido. Solo Banco Sabadell tenía además un llms-full.txt. En otras 4 no pudimos comprobarlo (una devolvía error 503 y tres, un 403 de su protección contra robots).
- Un 200 no demuestra nada. Mercadona, La Moncloa y la web de la Región de Murcia respondían «200» a la petición del archivo, pero con una página HTML. Es el error del recuadro de arriba, visto en directo.
- Los medios separan entrenar de citar. La Vanguardia y 20minutos cierran GPTBot y dejan abierto OAI-SearchBot: no quieren entrenar modelos, pero sí salir en las respuestas de ChatGPT. El País elige a quién: deja pasar a los robots de OpenAI y cierra los de Anthropic, Perplexity y Common Crawl.
- Algunos lo cierran todo. ABC y La Verdad prohíben la portada a once de los doce robots de la lista (todos menos Google-Extended). El SEPE, a diez, incluido OAI-SearchBot.
- Tiendas y bancos, puertas abiertas. Salvo Wallapop con CCBot, ninguna tienda ni banco de los que pudimos leer cierra el paso a un robot de IA. Para quien vende, salir en la respuesta pesa más que el miedo a que lo lean.
Moraleja para una pyme: tu situación se parece más a la de una tienda que a la de un periódico. Un medio vive de que lean su contenido en su web; tú vives de que te recomienden. Cerrar los robots de búsqueda te quita una vía de clientes a cambio de casi nada.
¿Merece la pena? Por dónde empezar si solo tienes una tarde
Respuesta corta: sí, pero en este orden. Primero el robots.txt, que decide quién te lee. Después el contenido y los datos que la IA usa para recomendar. El índice para IA, al final, como remate.
- Revisa tu robots.txt con la tabla de arriba y asegúrate de que OAI-SearchBot, PerplexityBot, Claude-SearchBot y Googlebot pueden entrar.
- Decide qué haces con el entrenamiento. Cerrar GPTBot o ClaudeBot es una decisión de principios, no de visibilidad. Las dos opciones son razonables.
- Marca tus datos con schema.org. Nombre, dirección, horario, productos y opiniones en un formato que las máquinas leen sin adivinar. Lo tienes con código para copiar en la guía de datos estructurados.
- Escribe el llms.txt con tus diez o veinte páginas clave y comprueba que se entrega como texto plano.
- Mira qué responde la IA de tu sector cada pocas semanas. Es la única prueba de que todo lo anterior está sirviendo.
El archivo es lo más barato de la lista y lo que menos mueve la aguja, así que no dejes que te quite tiempo de lo demás. Si quieres entender por qué las IA eligen unas fuentes y no otras, empieza por qué es el GEO. Y si prefieres que lo revise alguien que lo hace cada día, es parte de nuestro trabajo como agencia GEO, siempre con el SEO de base.
En Vértigo Marketing trabajamos el GEO y el SEO de empresas de toda España: miramos qué responden ChatGPT y Google sobre tu sector, en qué fuentes se apoyan y qué falta para que te nombren. Pide tu revisión gratis
Preguntas frecuentes
¿El archivo llms.txt mejora el posicionamiento en Google?
No. Google dice en su guía de IA generativa, actualizada el 10 de julio de 2026, que su buscador no usa estos archivos y que tenerlos no ayuda ni perjudica en visibilidad ni en posiciones. Puede servir para otras herramientas, pero no para Google.
¿Qué diferencia hay entre llms.txt y robots.txt?
El robots.txt da permisos: dice qué robots pueden entrar y por dónde, y los rastreadores serios lo respetan. El otro es solo un índice recomendado de páginas para modelos de lenguaje; no permite ni prohíbe nada. Si quieres controlar el acceso de la IA, el que cuenta es el robots.txt.
¿Cómo bloqueo GPTBot sin desaparecer de ChatGPT?
Pon un grupo «User-agent: GPTBot» con «Disallow: /» en tu robots.txt y deja permitido OAI-SearchBot, que es el robot de búsqueda de ChatGPT. GPTBot recoge contenido para entrenar modelos; cerrarlo no te saca de las respuestas con búsqueda. OpenAI calcula unas 24 horas para que el cambio se note.
¿Dónde tengo que poner el llms.txt?
En la raíz del dominio, junto al robots.txt, para que se abra en tudominio.es/llms.txt. Debe entregarse como texto plano con un 200. Si cada subdominio es una web distinta, cada uno necesita el suyo.
¿Cómo sé qué rastreadores de IA visitan mi web?
En los registros de tu servidor (los logs) aparece el nombre de cada robot en la cabecera user-agent: GPTBot, ClaudeBot, PerplexityBot y compañía. Para confirmar que son quienes dicen, OpenAI y Perplexity publican sus direcciones IP. Muchos hostings enseñan esos datos en su panel de estadísticas.
¿Puedo salir de los AI Overviews sin salir de Google?
Sí. Desde el 31 de agosto de 2026, Search Console tiene en Ajustes un control de IA generativa: si eliges excluir la web, deja de aparecer en los AI Overviews, el Modo IA y las funciones con IA de Discover en uno o dos días. Google dice que no afecta a las posiciones del resto del buscador.
¿Hace falta un llms-full.txt además del índice?
No es obligatorio ni forma parte de la propuesta original. Es útil en documentación técnica, donde alguien quiere pasarle todo el manual a un asistente de un tirón. En nuestra muestra de 34 webs españolas, solo una lo tenía.
Sigue leyendo
- SEO para IA: guía práctica para que ChatGPT, Gemini y Google te recomienden
- Modo IA de Google: cómo usarlo, cómo quitarlo y cómo aparecer en sus respuestas
- Datos estructurados y schema markup: código por tipo de negocio, validación y papel en la IA
- Qué es el EEAT (E-E-A-T) y cómo se nota en una web que inspira confianza
- Agencia GEO en España: posicionamiento en ChatGPT y en Google
- Las mejores agencias GEO de España
Fuentes
Las cifras y afirmaciones de esta guía salen de estas fuentes:
- llmstxt.org: la propuesta original de Jeremy Howard (3-9-2024)
- Google Search Central: optimizar la web para la IA generativa de Google (actualizada el 10-07-2026)
- Google Search Central: registro de cambios de la documentación (aclaración sobre llms.txt del 15-06-2026)
- Ayuda de Search Console: control de IA generativa de la Búsqueda
- Google: rastreadores comunes y Google-Extended (actualizada el 15-10-2026)
- OpenAI: GPTBot, OAI-SearchBot, ChatGPT-User y OAI-AdsBot
- Anthropic: ClaudeBot, Claude-SearchBot y Claude-User (actualizado el 07-04-2026)
- Perplexity: PerplexityBot y Perplexity-User
- Apple: Applebot y Applebot-Extended (04-09-2026)
- Meta: rastreadores web de Meta
- Common Crawl: CCBot
- Chrome Lighthouse: auditoría de llms.txt (actualizada el 05-05-2026)
- Yoast: cómo activar llms.txt en Yoast SEO
Por el equipo de Vértigo Marketing Publicado el Revisado el